协会地址:上海市长宁区古北路620号图书馆楼309-313室
在Kubernetes上构建AI工厂
来源: Cloud Native Computing Foundation
作者: Hrittik Roy | CNCF 大使及 vCluster 平台倡导者
发布时间: 2026年8月27日 19:30:00
原文链接: https://www.cncf.io/blog/2026/08/27/building-an-ai-factory-on-kubernetes/
发布于 2026 年 8 月 27 日,作者:Hrittik Roy | CNCF 大使及 vCluster 平台布道师
AI 工厂(AI factory)不仅仅是模型或集群。它是一个 GPU 资源池,多个团队可以同时从中取用:一个团队在微调(fine-tuning),另一个在提供推理(inference)服务,第三个在运行评估,全部跑在同一批加速器上。NVIDIA 将其定义为“覆盖完整 AI 生命周期的基础设施,从数据准备到训练、微调,再到大规模推理”。在企业环境中,这意味着一个资源池、多个团队,以及叠加在上面的不同配额、策略和信任边界。难题不再是怎样训练模型,而是如何让每个团队都能安全、隔离地访问同一套昂贵硬件,而不互相干扰。
两年前,每个平台团队都在构建开发者平台。Kubernetes 在容器、RBAC(基于角色的访问控制)、自动扩缩和策略方面已经具备成熟的基元。它所欠缺的,是对加速器的清晰支持,以及在相同节点上隔离不同租户的能力。这正是 AI 工厂需要弥合的缺口,而云原生生态如今已经提供了弥合该缺口所需的大部分组件。
瓶颈在于利用率,而非模型服务
加速器是机房中最大的资本支出,而决定这笔投入是否值得的指标是利用率,而非单次运行得出的峰值每秒令牌数。市场评估 GPU 云的方式与之相同。SemiAnalysis 的 ClusterMAX 从安全性、网络、存储、可靠性和支持等方面对服务商进行评分,而非只看原始吞吐量;其安全标准奖励严格的逐租户隔离,细到为每个租户提供独立的 Kubernetes 集群和基于 DPU 的隔离,同时标记出薄弱边界——例如将多个租户放在同一个集群上。被评判的是 GPU 的外围封装,而非 GPU 本身。
两件事导致利用率低下。首先是资源模型:在传统的设备插件(device-plugin)模型中,Pod 请求 nvidia.com/gpu: 1,即使仅使用 10% 也会独占一整块加速器。Kubernetes 1.34 中正式可用的动态资源分配(DRA)让调度器能够将加速器视为具有属性、内存和拓扑的富设备,不过它本身并不能将 GPU 切分为分数份额;密度来自底层的设备层。其次是隔离模型:为了隔离团队,平台默认按团队分配专用集群或一组专用 GPU——在信任边界严格时这是安全选择,但也造成了大部分硬件浪费。
同样的模式在现场反复出现:运维人员使用裸金属(bare metal)置备工具和手工变通方案来管理租户,或者将一整块专用 GPU 交给每个客户,并拒绝那些无法干净隔离的需求。解法不是新的模型服务器,而是一个能够分配加速器的技术栈——既不让算力闲置,也不牺牲安全,并隔离租户,使它们紧密打包在一起仍然安全可靠。
技术栈,逐层拆解
AI 工厂是一个组装问题。大多数层采用 Kubernetes 原生方案或 CNCF 项目,另辅以少数开源工具,如 NVIDIA 的 MIG、vCluster 和 Dynamo。下图展示了整体架构,表格列出了每一层所承担的工作。
| 层 | 职责 | 基础组件 |
|---|---|---|
| 硬件生命周期 | 置备并验证裸金属 | Metal3 / Ironic、Tinkerbell、Redfish、NetBox |
| 集群生命周期 | 创建并管理集群版本,GitOps | NVIDIA AICR |
| 节点清单 | 标记 GPU、NIC(网卡)、MIG、拓扑 | Node Feature Discovery、GPU 与网络 Operator(NVIDIA、AMD) |
| 租户隔离 | 在同一硬件上隔离不同团队 | vCluster |
| GPU 分配 | 分配并调度加速器 | 拓扑感知调度 |
| 推理与服务 | 在 API 背后运行模型 | vLLM、KServe、llm-d |
| 批处理与 HPC | 运行 SLURM 工作负载 | Slinky(基于 Kubernetes 的 SLURM) |
| 虚拟机 | 为租户运行虚拟机 | KubeVirt |
| 网关与自动扩缩 | 路由并扩缩端点 | Gateway API、Envoy、LiteLLM、KEDA、HPA |
| 网络 | 在 GPU 之间传输数据,隔离租户 | Cilium、Multus、SR-IOV、基于 RDMA 的网络解决方案 |
| 存储与数据 | 持久化数据集、检查点、模型 | CSI、Rook / Ceph、并行文件系统 CSI、对象存储 |
| 可观测性 | 查看利用率、日志、链路追踪 | Prometheus、OpenTelemetry、DCGM exporter |
| 身份与策略 | 认证、授权、配额、护栏 | Keycloak(OIDC)、ResourceQuota / Kueue、Kyverno 或 OPA |
| 密钥与安全 | 密钥、运行时、供应链 | OpenBao + External Secrets、Falco、Trivy |
| 可靠性与修复 | 检测节点故障并从故障中恢复 | DCGM 健康检查、Node Problem Detector、drain / cordon |
| 自助服务与计费 | 为租户开通资源并计费 | API / OpenTofu / GitOps、OpenCost、DCGM GPU-秒 |
从裸机到验证容量
一切始于机架。
以典型的现代AI超算平台为例。在任何一个GPU能够运行工作负载之前,必须有某个环节将原始服务器转化为可用的资源池。这就是配置层(provisioning layer),通常是随系统交付的专有硬件管理器。
它按步骤运作。首先发现每个节点并进行盘点:有哪些GPU、数量多少,内存是否健康(ECC状态,意味着纠错功能已开启且未记录故障),以及网卡的标识(InfiniBand GUID和NIC MAC地址,即用于节点联网和启动的永久硬件ID)。接下来,它对节点进行网络引导,并安装一个集成了GPU驱动以及CUDA和NCCL库的操作系统镜像,使节点一上线即可进行计算。随后,它会应用与节点目标匹配的BIOS设置:基线(baseline)、性能(performance)或机密计算(confidential-compute)。
节点加入资源池之前必须经过测试。这种老化测试(burn-in)让节点在负载下运行,以捕获早期故障,同时NCCL测试确认GPU之间确实能以全带宽通信。测试结果写入NetBox之类的可信数据源(source of truth),该数据源同时负责跟踪IP地址分配(IPAM)。退役节点则反向执行该流程:擦除磁盘、重置远程管理登录(如BMC),然后将清洁的节点归还资源池。
该专有管理器是厂商对这一层的全栈一体化方案,与其自身系统紧密耦合。另一条路径是用开源积木拼装出同样的闭环:Metal3驱动Ironic,或类似vMetal的解决方案,让你按照自己的方式实现同样的发现、镜像、验证和回收周期,而不是整体采纳厂商的技术栈。这就是“自建”与“拼装”之选,而上方的每一层都会反复遇到相同的选择。我将在文末回到这个话题。
GPU分配:让经济账成立的那一层
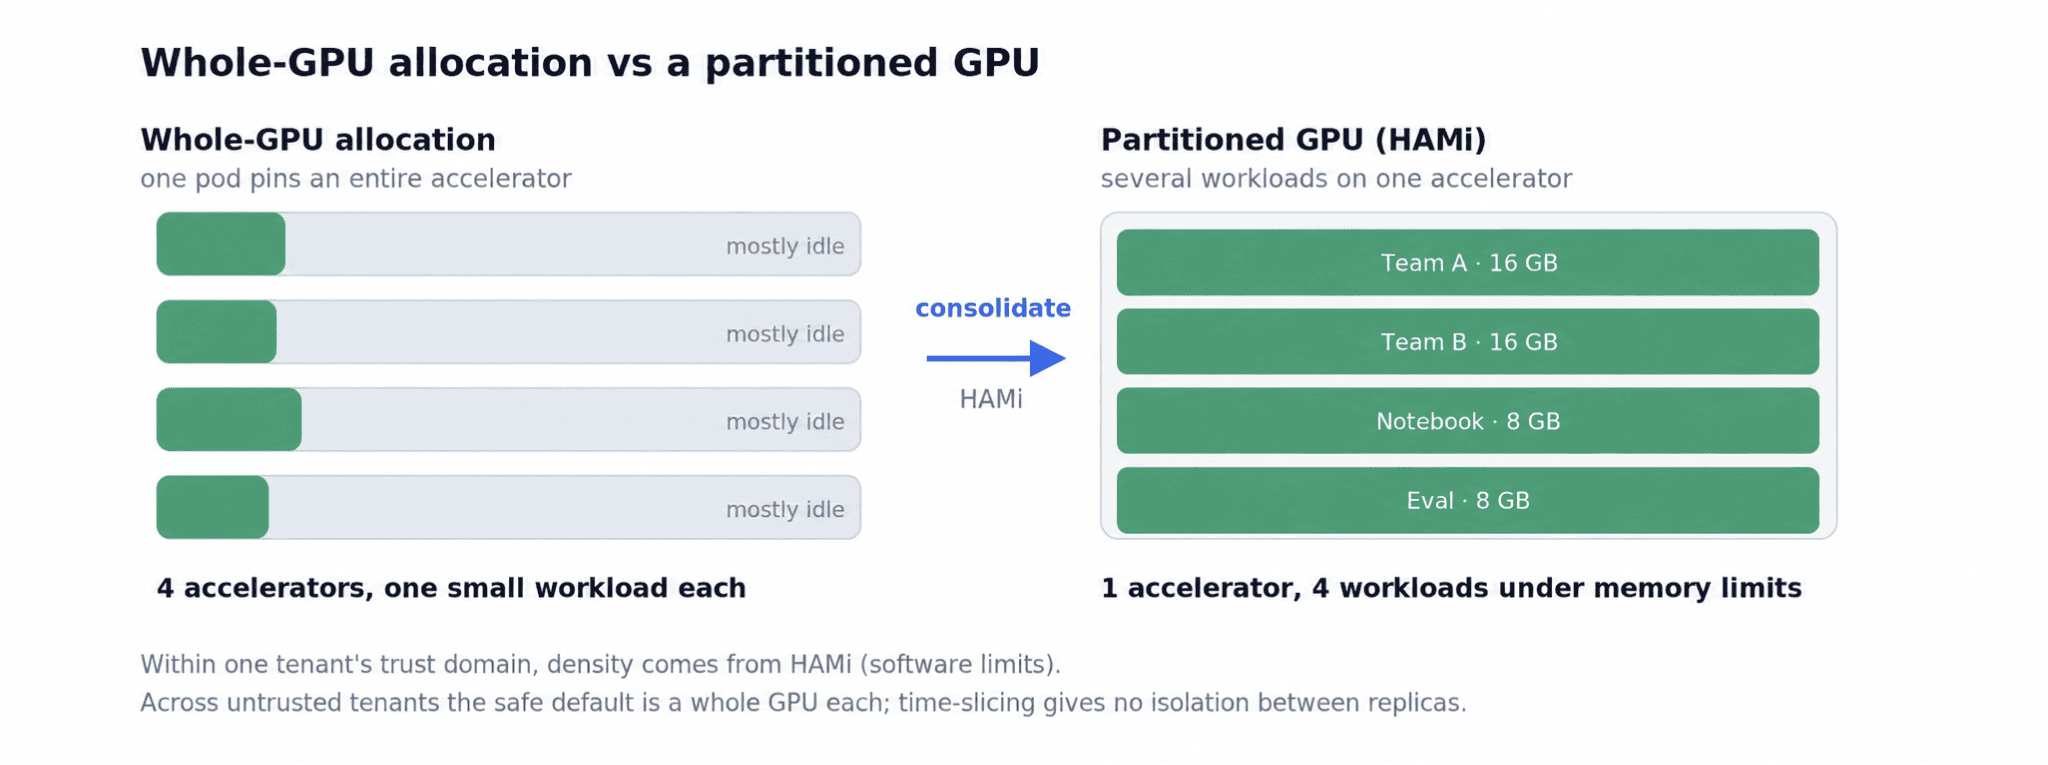
图 1. 整 GPU 分配与分区 GPU 的对比
DRA 提供了更丰富的设备声明模型,但资源分片密度来自设备实现。HAMi 是一个 CNCF 孵化项目,它在软件层面实施每个 Pod 的内存和计算限制,使多个 Pod 可以在一块显卡上运行,并在它们之间设置护栏,同时支持多个加速器厂商。
对于走向机密计算的运营商,他们不会将不受信任的租户放在同一块物理 GPU 上,而是给每个租户一整块 GPU,并将分区保留给单个信任域内的工作负载。MIG 确实在硬件上隔离内存和故障,但它作为敌对租户之间边界的用途仍存在争议,因此保守的默认配置是每个租户独占整块 GPU。该层有两个任务:整 GPU 分配用于租户隔离,分区用于租户内部的密度。调度是分开的:KAI Scheduler 和 Volcano 处理 gang 调度和拓扑感知放置,Kueue 处理排队、准入和配额。
工作负载层:服务、Slurm 和虚拟机
在分配之上是团队实际运行的内容。对于推理,vLLM 是常用引擎,KServe 是一个 CNCF 孵化项目,为它封装了自动缩放和标准端点,而 NVIDIA Dynamo 和 llm-d 则推动更大规模部署中的分离式推理。在前端,Gateway API 负责路由,LiteLLM 添加了一个兼容 OpenAI 的网关,使数十种专用模型可以通过同一个 API 进行通信。
训练客户通常使用 Slurm,目前的模式已收敛为通过 SchedMD 的 Slinky 在 Kubernetes 上运行它。Slinky 将 Slurm 守护进程表示为 CRD,并与 GPU Operator 和 DRA 集成,以实现拓扑感知调度,配合 pyxis 和 enroot、以完整 NCCL 带宽运行的 GPUDirect RDMA,以及 prolog 和 epilog 健康检查。有些租户希望使用普通虚拟机而不是 Pod;KubeVirt 将虚拟机作为 Kubernetes 工作负载运行,因此一个平台可以在相同的 RBAC 和配额下,从同一个资源池中同时提供容器和虚拟机。
网络、存储和可观测性
训练和分离式推理受带宽约束,因此网络是设计的一部分。Cilium 负责主 CNI 和网络策略;在快速路径上,Multus 和 SR-IOV 直接暴露网卡,并通过 RoCEv2 或 InfiniBand 上的 RDMA 承载节点间 GPU 流量,隔离层不介入该数据路径。
真正的云还会为租户提供他们期望的云边服务:弹性 IP、NAT,以及来自网络结构前端网关的 L4 负载均衡。存储需要按租户持久化,通常使用 CSI 配合 Rook 和 Ceph,或并行文件系统,并由按租户的 StorageClass 和配额进行管理。
在可观测性方面,OpenTelemetry 是中立的采集层,使后端可以替换;Prometheus 负责指标,VictoriaLogs 负责日志;DCGM exporter 发布 GPU 遥测数据,这些数据只有结合标签和成本管线才能按租户区分,OpenCost 则将 GPU 秒转换为成本分摊。
可靠性与安全性
在集群规模下,GPU 会持续发生故障:ECC 错误、从总线上脱落的显卡、NVLink 故障和热相关故障。运维人员的工作是在租户发现问题之前捕获这些故障,这使得健康检查成为一等组件层,而不是仪表盘上的事后补充。
基于 DCGM 的主动和被动检查监测性能下降,Node Problem Detector 将硬件信号转换为节点条件,修复循环会在新工作负载落到可疑节点之前将其封锁并排空。这是评级系统权重最高的类别之一,因为客户首先感受到的是可靠性,而不是峰值吞吐量。身份和策略补全了该层:基于 OIDC 的 Keycloak、配合 External Secrets Operator 的 OpenBao、用于护栏的 Kyverno 或 OPA,以及用于运行时和供应链的 Falco 和 Trivy,审计日志导出到可观测性栈,传输中的数据会加密。
隔离租户
以上每一层都假设一件事:你可以安全地在同一硬件上运行多个团队。这就是租户隔离问题,它有两个值得分开讨论的部分。
第一部分是控制平面。租户集群模式为每个团队提供一个虚拟控制平面:一个完整的 Kubernetes API 服务器,拥有自己的 CRD、准入 webhook、版本和 RBAC,作为单个底层集群上的工作负载运行,且无法查看其他租户。多个 CNCF 和开源项目实现了这种模式,例如 vCluster。由于每个租户集群都是符合标准的 Kubernetes,可以使用普通的 kubectl、Helm 和 Argo CD,无需专有扩展,因此该模式为租户提供了干净的退出路径,而不是锁定。
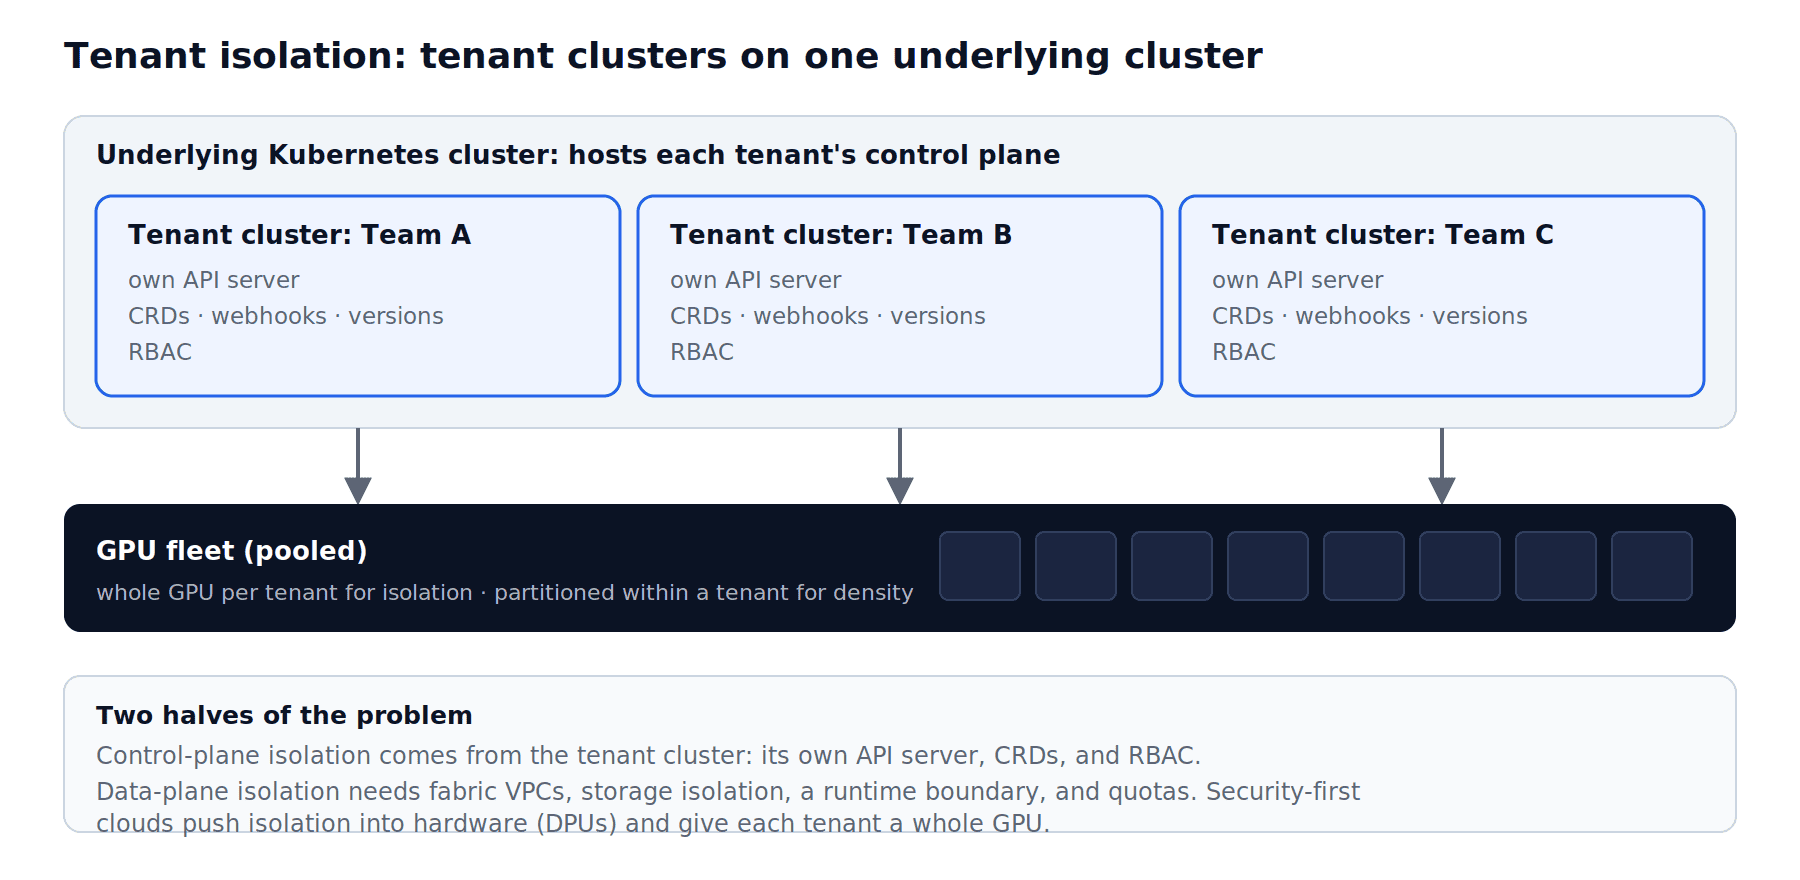
图 2. 底层集群之上的租户集群,从池化 GPU 资源池中获取资源。
在实践中,运营方通常运行两层架构。高信任度或企业级租户获得专用集群,有时甚至是专用硬件,其边界是物理隔离;规模较小或对成本敏感的租户则在池化容量上获得租户集群。同一控制平面驱动这两层架构。可靠性源于相同的设计:由于租户控制平面以 Pod 形式运行,Kubernetes 会在故障时重新调度它,而悬而未决的问题在于爆炸半径,因此运营方会限制单个底层集群承载的租户数量。
后半部分是数据平面,租户集群本身无法独立解决这一问题。你仍然需要网络隔离、存储隔离、配额、Pod 安全以及运行时边界。网络隔离通常来自网络架构而非 Kubernetes:控制平面在以太网侧通过 VXLAN 和 EVPN 为每个租户划分 VPC(虚拟私有云),在 InfiniBand 侧则通过分区键实现。这种强制机制正越来越多地被下沉到硬件中,诸如 NVIDIA BlueField 或 AMD Pensando 等 DPU(数据处理单元)将隔离和加密从主机 CPU 上卸载下来,这也是运营方实现机密计算能力的方式。
对于共享节点上的运行时边界,可选方案从专用节点到 vNode 等沙箱运行时不一而足。真正云服务的标准是硬件强制的隔离,而非命名空间加上良好意图。
是什么让它成为一朵云,而不仅仅是基础设施
一堆 GPU 与一朵云之间的分界线在于:客户能否自行开通资源,并获得一张清晰合理的账单。这两者都是云原生问题。自助服务意味着 API 优先,不存在仅限 UI 的路径:租户通过 API、Terraform Provider 或 GitOps 创建和删除集群,资源以声明式 CRD 表达,由 Flux 或 Argo CD 进行调和,访问权限通过 OIDC 结合 RBAC 进行范围控制。
账单来自计量层:基于 DCGM 驱动的 GPU 秒级计量和 OpenCost 资源分摊,按租户分别导出。这些工作都不光鲜,但通常正是实验室与产品之间最大的鸿沟。而且,比起原始性能,这才更贴近客户的日常体验。
从演示到生产
将整个技术栈组装起来,演示非常简单:两个团队、两个租户集群、两个模型端点、一块通过 MIG 或软件限制进行分区的物理 GPU,每个租户各有自己的 RBAC、网络策略、指标和成本核算,互不可见。这一方案已在 KubeCon + CloudNativeCon 大会上做过现场演示:一块现代 GPU 同时服务两个模型。
将其转化为生产环境需要两件事。第一是一致性认证:诸如 NVIDIA 的 AI Cluster Runtime 之类的工具会根据你实际拥有的硬件验证集群配置,并生成可复现的 Helm 或 GitOps 工件;而 Kubernetes 1.35 版本中引入的 Kubernetes AI Conformance 计划则将该理念提升到平台层面。
第二是规模:该设计必须在数百个 GPU 节点和多个数据中心的环境下成立,而不只是你做验证的那几台机器——这正是以 GitOps、声明式租户和单一事实来源为基石的真正原因。这里也存在一个战略选择:由于硬件厂商正以集成套件 NVIDIA DSX OS 进入这一层,运营方需要逐层决定是采用它、用云原生项目组装出等效方案,还是两者组合使用。
结语
AI 工厂不是又一个 AI 平台或模型服务产品。它是一种在 Kubernetes 上大规模运行 GPU 基础设施的运营模式。正如 Kubernetes 成为云原生应用的操作系统一样,它正在成为 AI 基础设施的基石,让 GPU 成为可调度的资源,为租户提供隔离环境,并实现按需计算。挑战不在于部署 MIG、DRA、HAMi 或 vLLM 等技术,而在于将它们组合成一个在利用率、隔离性和成本之间取得平衡的平台,让多个团队在无损性能或安全性的前提下安全共享昂贵的 GPU 基础设施。
软件只是其中一半。硬件层的难度同样大,甚至更高。拓扑结构决定性能:哪些 GPU 共享 NVLink 或 NVSwitch 域、每个节点如何接入 rail-optimized 的 InfiniBand 或 RoCE 网络、GPU、NIC 和 CPU 是否位于同一 NUMA 节点上、GPUDirect RDMA 是否拥有干净的路径。如果调度工作负载时不考虑这些因素,集合通信就会在速度最慢的跳点上停滞——无论平台在纸面上看起来多么健康。整个技术栈必须具备拓扑感知能力,而不仅仅是资源感知。
难点不在于罗列工具。而在于让资源密度、隔离和成本分摊协同工作,在信任模型要求的地方实施硬件强制边界,同时不把 GPU 数据路径隐藏在抽象层之后。